Разбор · Опубликовали 21.09.2026
Модель Jev не пишет текст, а решает: мы дали ей судить нашу ленту новостей
Jev от TypeSafe AI отвечает на вопросы с готовыми вариантами и числом уверенности, а текст не пишет вовсе. Мы прогнали через неё двести постов нашей ленты и сверили с нашим судьёй: при подобранном пороге совпали в трёх случаях из четырёх, ответ из РФ приходил за 0,42 с, весь прогон стоил три цента.
Текст собран ИИ-агентами редакции под надзором автора · факты проверены по первоисточникам 21.09.2026 · наш прогон на ленте 21.09.2026, срез и код открыты
Каждый, кто строит что-то с ИИ, рано или поздно просит большую модель об одном и том же: «это спам или нет», «в какой отдел», «насколько зол клиент». Модель на такой вопрос думает секунды и берёт деньги за слова, которых никто не просил. 15 сентября TypeSafe AI выпустила Jev, модель, которая слов не пишет вовсе: только вариант из вашего списка и число, насколько она уверена.
Вендор обещает ответ за доли секунды и цену в сотни раз ниже. Мы не стали верить на слово: у нас есть своя лента новостей, где решение «брать или нет» каждый час выносит большая модель. Мы дали Jev пересудить двести постов и сверили. Дальше по порядку: что это вообще такое, где подвох в бесплатном выходе, что показал наш прогон и как подключить её из РФ.
1. Что такое Jev и почему это не чат-бот?
Jev не отвечает текстом. Вы отдаёте ей состояние программы, будь то письмо, тикет или запись из базы, и список вопросов, у каждого из которых варианты ответа заданы заранее. Она возвращает по каждому вопросу выбранный вариант и вероятности всех вариантов. Это сортировщик на почте, который не пишет писем, а раскладывает их по коробкам и ставит штамп «уверен на девяносто».
Вопросов три вида. Choice выбирает один пункт из списка, в котором может быть до 255 вариантов. Score ставит оценку по шкале от двух до десяти уровней. Noul отвечает «да» или «нет» числом от 0 до 1. К одному тексту можно задать сразу десятки вопросов, модель считает их все параллельно, и время ответа почти не растёт.
Разницу вендор показал одним кадром. Один тикет поддержки с тремя десятками вопросов отдали Jev и GPT-5.6 Terra. Jev вернула все ответы за десятую долю секунды, большая модель в этот момент ещё ждала первый токен.
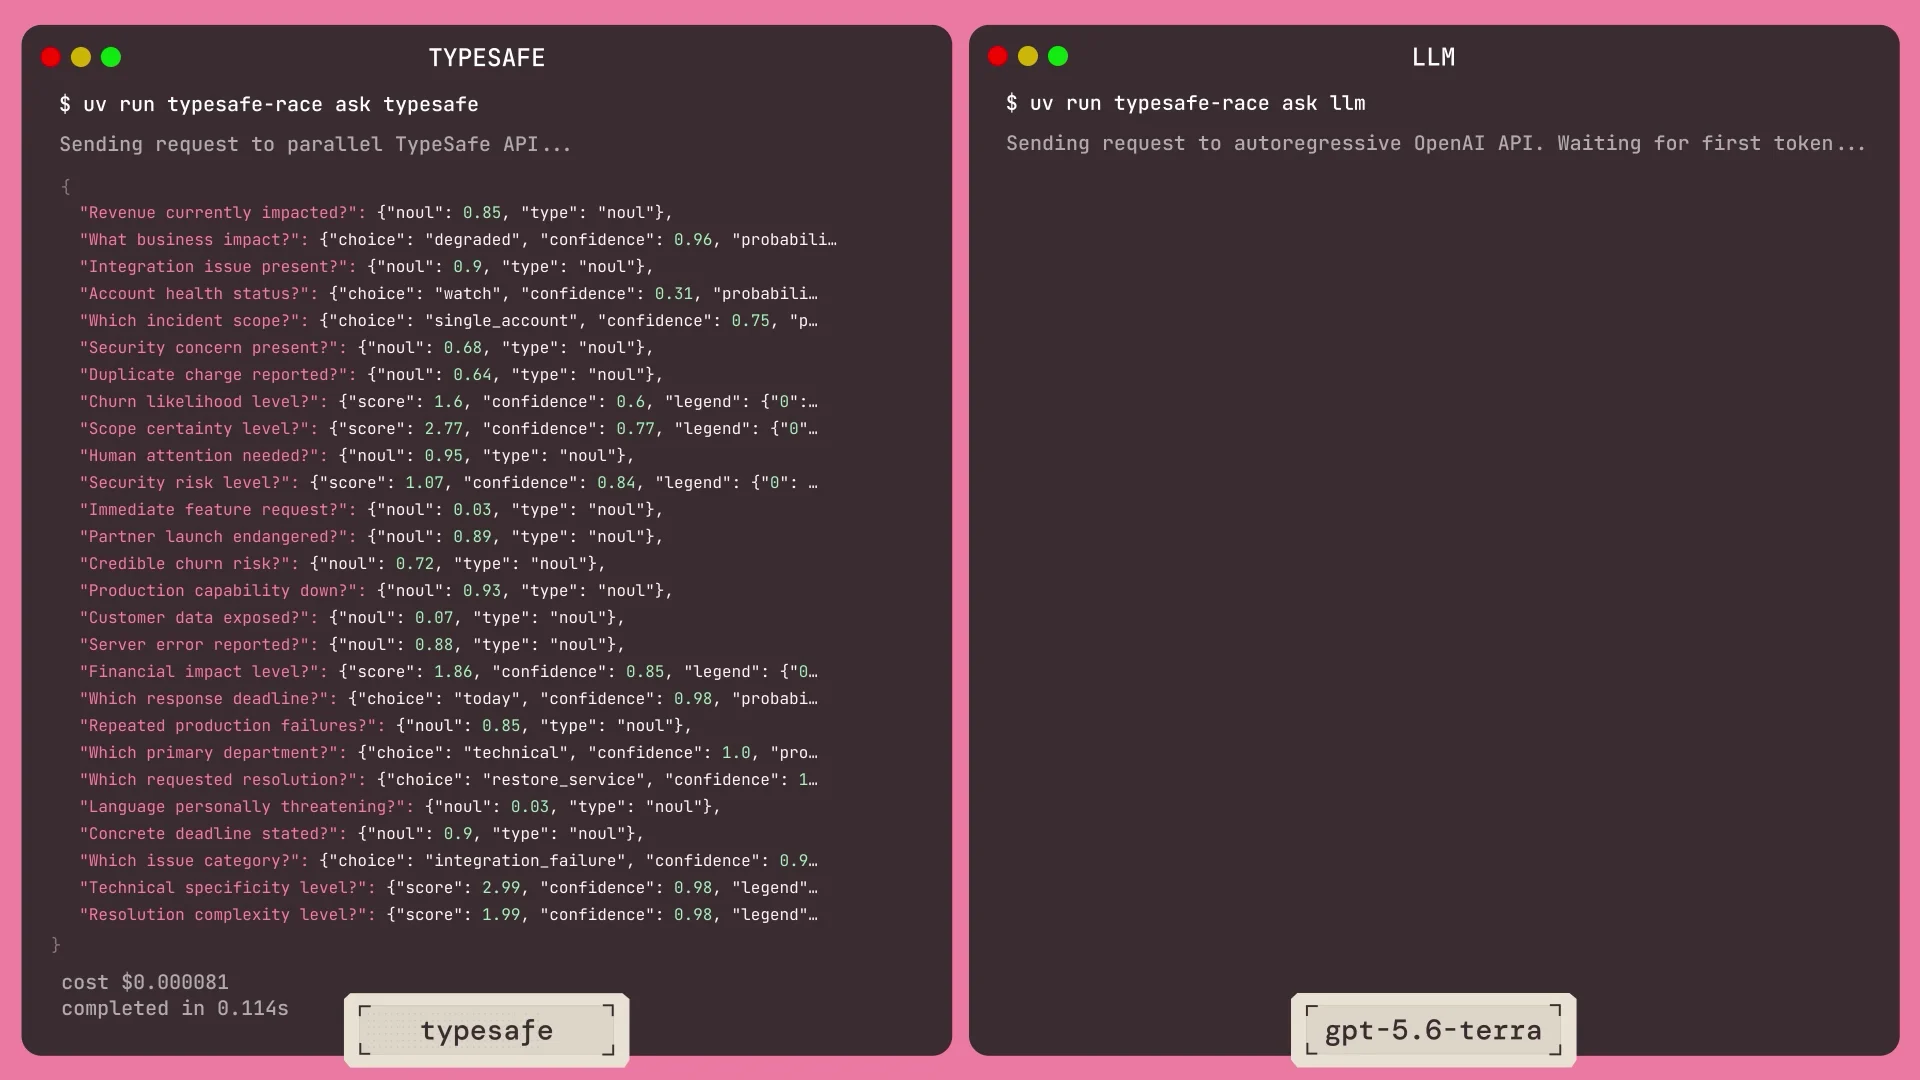
Компания зовёт это System One model, по книге Канемана о быстром и медленном мышлении: быстрая интуиция вместо долгих рассуждений. Обучена модель методом, который TypeSafe назвала RLCD, обучение с подкреплением для калиброванных решений. Научной статьи ни по классу моделей, ни по методу на 21 сентября нет, есть документация и блог. Автор модели, Диого Алмейда, один из основных авторов InstructGPT, работы OpenAI 2022 года, из которой вырос ChatGPT.
2. Чем Jev отличается от LLM и от обычного классификатора?
От большой модели Jev отличается тем, чего не умеет. Она не пишет текст и код, не смотрит картинки и не рассуждает шагами. Взамен она не тратит время на генерацию: LLM выдаёт ответ слово за словом, Jev считает все вопросы к тексту за один проход, поэтому выходные токены у неё бесплатны, их почти нет.
Казалось бы, это старый добрый классификатор, каких с 2018 года наплодили тысячи на BERT. На Hacker News так и написали: «скорее большая классификационная модель, чем языковая», и основатель ответил «очень точно». Разница всё же есть, и она главная для практика. Классификатор на BERT надо обучать под каждую задачу на своих размеченных данных. Jev берёт задачу из текста вопроса, обучать ничего не нужно.
За удобство платят точностью. Маленькая модель, обученная на тех же данных, дала на наборе Banking77 93,3% против 83,2% у Jev и отвечала в сорок раз быстрее (ickma2311, 18.09.2026). Если у вас одна задача, много размеченных данных и инженер, свой классификатор выиграет. Если задач десяток и данных нет, Jev закрывает их все одной формулировкой.
Три способа получить решение из текста
Документация TypeSafe и прайсы вендоров, проверено 21.09.2026; время ответа своего классификатора и Jev по прогону ickma2311 от 18.09.2026.
3. Сколько стоит и где подвох в бесплатном выходе?
Цена одна: $0,042 за миллион входных токенов, выходные токены бесплатны. В своих документах вендор считает в миллиардах, $42 за миллиард. Отдельной страницы тарифов у TypeSafe нет, минимального платежа и бесплатного уровня в документации не описано, цена стоит только в описании модели.
Подвох не в цене, а в единице. У большой модели выход стоит дороже входа, потому что модель генерирует слова. У Jev выходом служит набор вероятностей по заранее заданной схеме, генерировать нечего, поэтому и метить нечем. Сравнивать «$0,042 против $3 за миллион» в лоб нельзя: это разные единицы работы, и честно сравнивать только цену одной задачи.
По цене задачи цифры такие. Тысяча документов слушаний обошлась в $0,22 против $1,31 у DeepSeek без рассуждений (Эмиль Линдфорс, 18.09.2026). Проверка девяти тысяч пар товаров стоила $0,32 (paddo.dev, 19.09.2026). Наш прогон в 768 вызовов вышел в три цента. Ещё одна оговорка от самого вендора: в блоге TypeSafe пишет, что не может доказать отсутствие субсидии и ждёт, что цена пойдёт вниз, а на главной странице утверждает, что уже обслуживает модель прибыльно.
Дешёвые модели для решений: цены за миллион токенов
Прайсы вендоров, проверено 21.09.2026.
4. Правда ли в двести раз быстрее?
Смотря против кого мерить. У самого вендора четыре разные цифры на четырёх поверхностях: в ролике «в сто раз», в пресс-релизе «до ста раз», в блоге «в 40–200 раз», на главной «193,6 раза быстрее и 444,6 раза дешевле». Последняя пара выведена из его же замера на четырёх рабочих задачах, и вендор сам называет её верхней границей.
Мы пересчитали его таблицу. 193,6 получается делением 78,1 с у Claude Sonnet 5 на 0,4 с у Jev, а 444,6 делением $0,176 у Opus 5 на $0,0004. Скорость сравнена с самой медленной моделью в таблице, цена с самой дорогой. При этом по точности в том же замере Jev набрала 67,8% против 74,1% у GPT-5.6 Sol, честная рамка здесь не «умнее», а «дешевле при сопоставимой точности».
Независимые прогоны сходятся на скромной цифре. Против дешёвых больших моделей Jev быстрее в два-три раза: 239 мс против 687 мс у Claude Haiku 4.5 из Франции (JevBench, 20.09.2026), 0,43 с против 0,9 с у GPT-5.4 nano (ickma2311). Против моделей с рассуждениями разрыв больше: DeepSeek думал над документом 26 с, Jev 0,32 с.
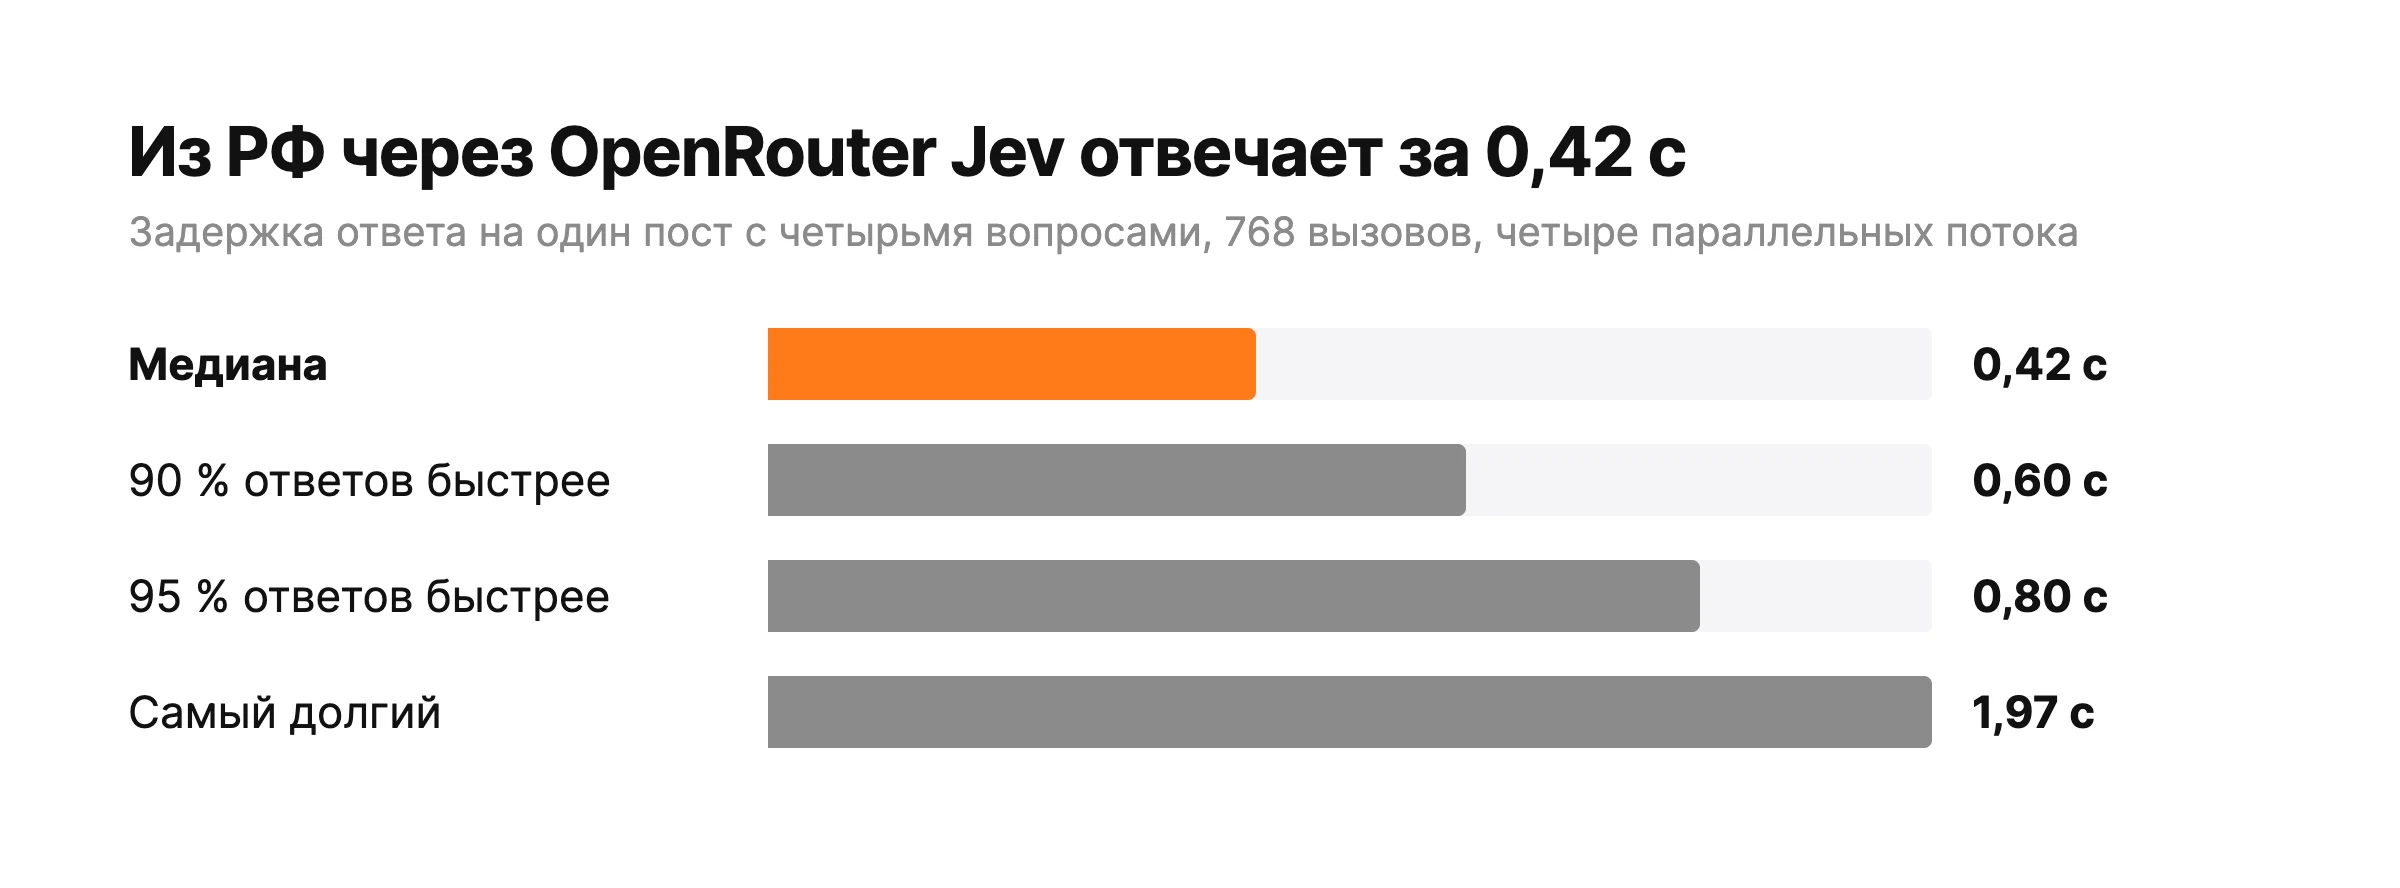
Наш собственный замер задержки ниже. Из РФ через OpenRouter, четыре потока параллельно, медиана 0,42 с на пост с четырьмя вопросами. Обещанные вендором «70–500 мс» с оговоркой «с наших ноутбуков на Западном побережье» у нас через шлюз и океан подтвердились почти целиком.
5. Мы дали Jev судить нашу ленту: что вышло?
У нас есть готовая задача под Jev. Лента новостей vibecoding.ru собирает посты практиков из X и заметки из RSS, а раз в час большая модель решает по каждому: по теме ли это для тех, кто строит софт ИИ-инструментами, какого типа пост, в какую полосу ленты его класть и сколько баллов из десяти он стоит. За неделю судья вынес 857 решений.
Мы взяли последние 200 постов из X и 184 заметки из RSS с решениями судьи и задали Jev те же четыре вопроса, что стоят в промпте судьи: по теме или нет, тип, полоса, балл. Каждый пост уходил отдельным запросом с автором, текстом, лайками и просмотрами. Судья видит батч из 25 постов и живые сюжеты ленты, Jev видела один пост без контекста. Сверяли с решениями судьи, не с разметкой людей: это совпадение вкусов двух моделей.
Главный результат про порог. Если считать ответом «да» вероятность выше 0,5, Jev нашла лишь 13% постов, которые судья взял в ленту: она много осторожнее нашего судьи. Но её вероятности честно ранжируют посты. Среди тех, где Jev дала от 10 до 20%, судья взял 41%; где от 20 до 30%, уже 69%; где выше 60%, все до одного. Чем увереннее Jev, тем чаще судья согласен, просто её шкала сдвинута вниз.
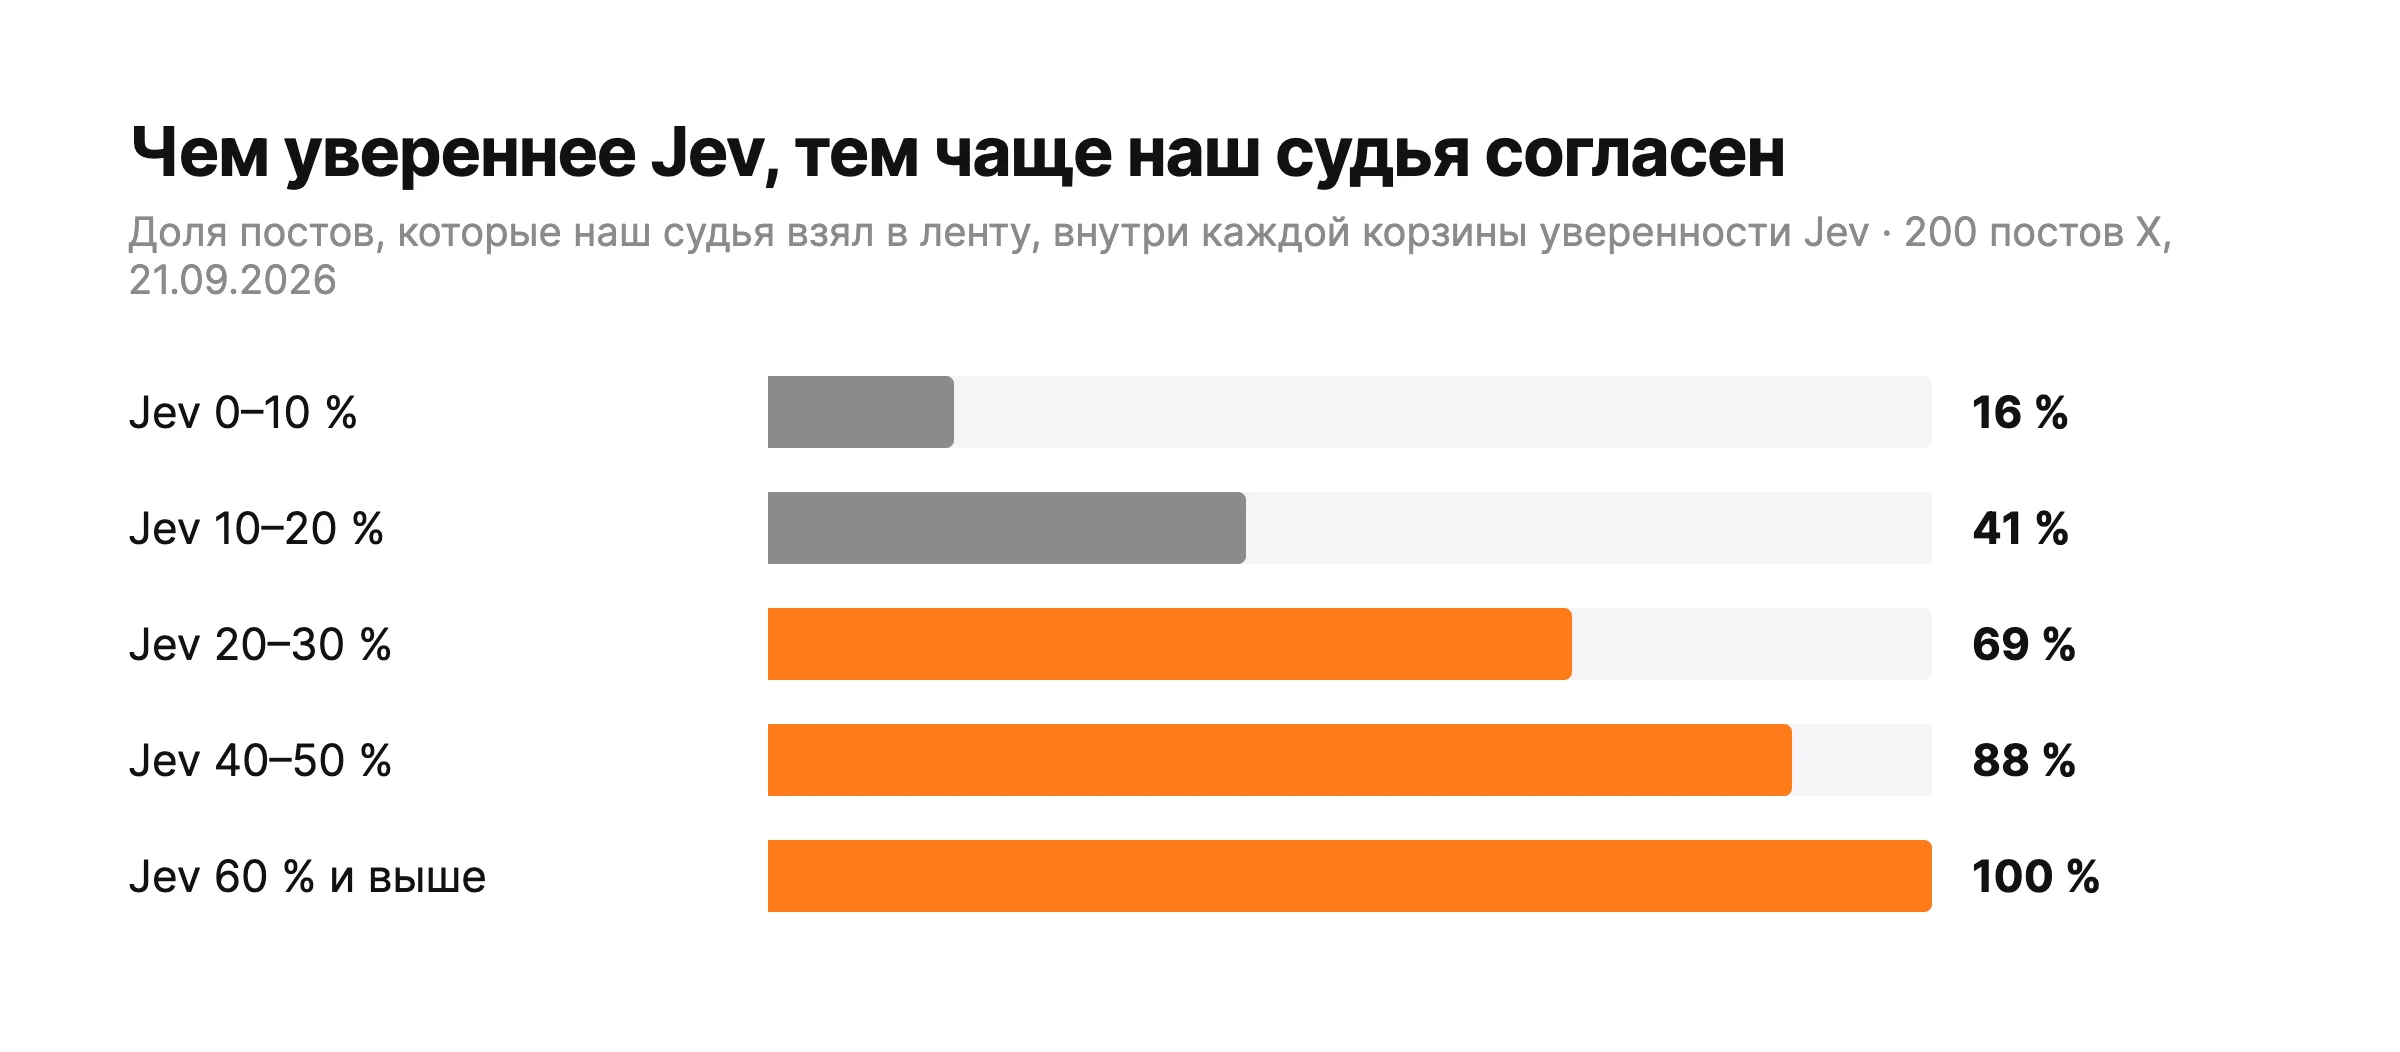
Поэтому порог для нашей задачи стоит ставить не на 0,5, а на 0,2. Тогда Jev совпадает с судьёй в 76,5% решений и находит почти половину постов, которые он взял, с одним ложным срабатыванием на три верных. Таблица ниже показывает, как согласие меняется с порогом.
Согласие Jev с нашим судьёй на 200 постах X при разных порогах
Наш прогон 21.09.2026, английские вопросы. Судья ленты: большая модель по промпту judge-v8 с эталонами владельца.
Где Jev и судья спорят, спор осмысленный. Судья ставил семёрку постам Илона Маска, потому что в его эталонах есть такие посты, которые редакция раньше пропускала и жалела. Jev давала им от 0,01 до 0,07: она судит с нуля по формулировке вопроса, никаких эталонов вкуса у неё нет. Зато несколько постов Тоби Лютке и Гильермо Рауха про рабочие приёмы обе модели взяли уверенно.
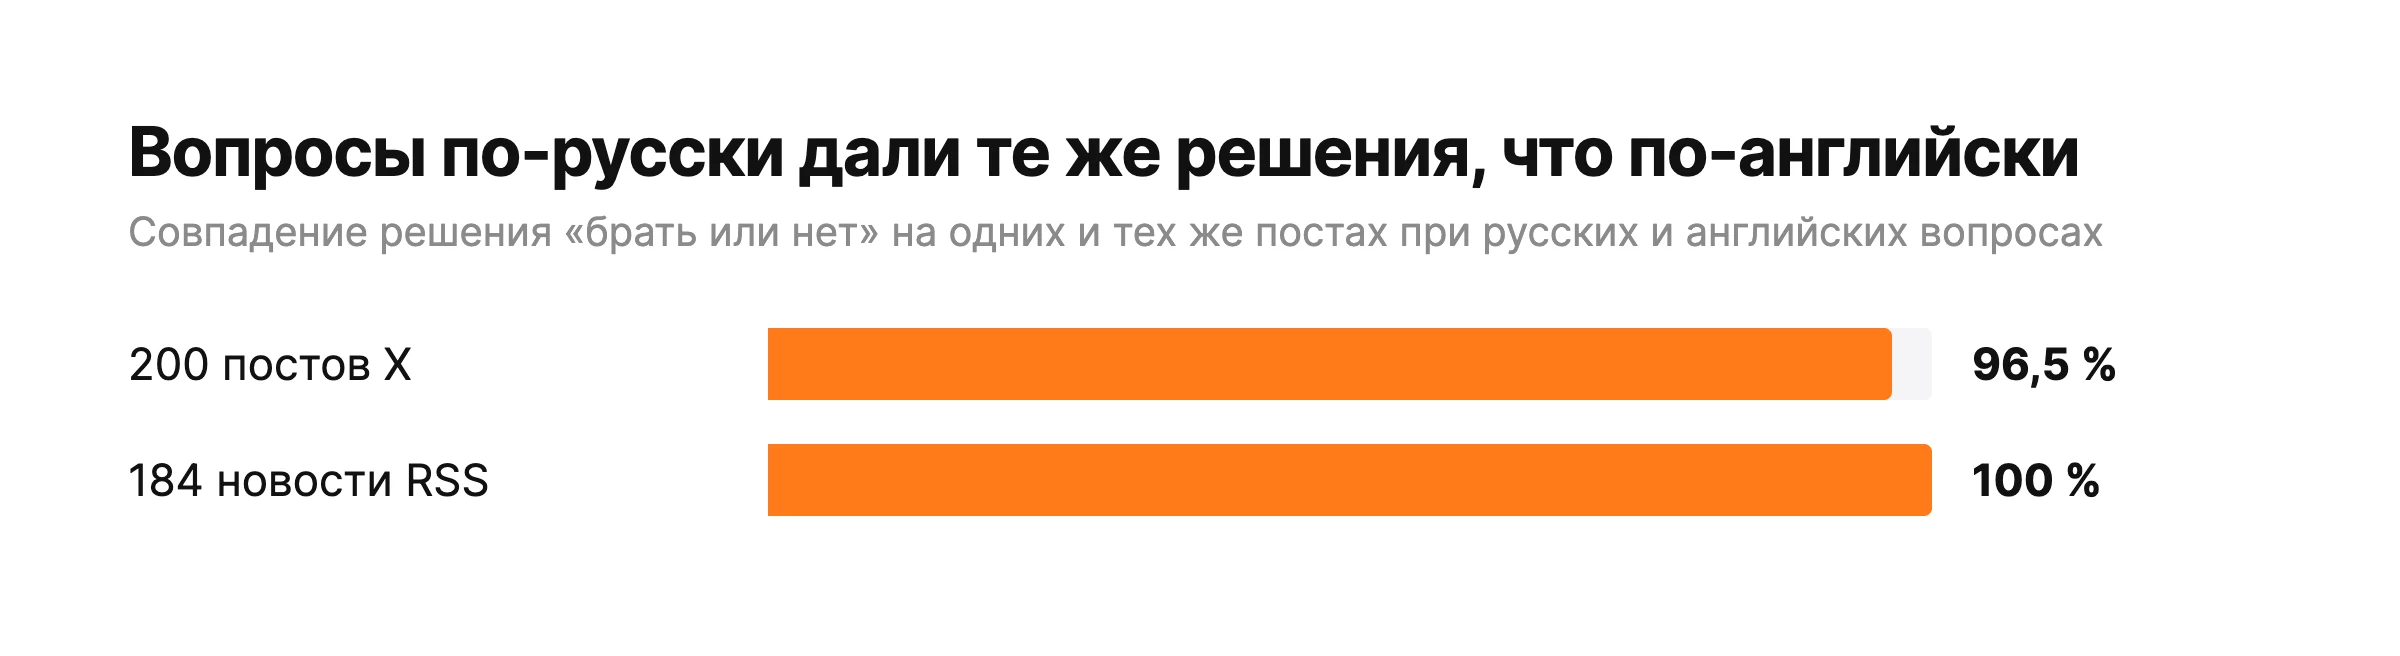
Про русский язык вышло неожиданно. Мы повторили прогон, переведя все четыре вопроса на русский. Решение «брать или нет» совпало с английским вариантом на 96,5% постов X и на всех 184 заметках RSS, медиана разницы вероятностей 0,01. Русские вопросы стоят на 58% больше входных токенов, и это вся цена.
Русские тексты дались хуже, но это не про язык. Наша RSS-полка почти целиком состоит из деловых СМИ, РБК, CNews, Коммерсантъ, и судья берёт оттуда по своим мягким правилам 28 заметок из 184. Jev при пороге 0,5 не взяла ни одной, при 0,15 три. Развести здесь «не знает русского» и «не наша тема» без отдельного набора нельзя, вендор пишет только, что английский у модели основной язык.
Что мы из этого вынесли. Заменить судью ленты Jev не заменит: он видит сюжеты и вкус редакции, она видит один пост. А вот первый фильтр перед дорогим судьёй из неё выходит: всё, что ниже 0,1, наш судья тоже берёт лишь в одном случае из шести, и таких постов больше половины. Отсечь их за три цента и 0,4 с на пост вместо полного прогона большой модели, это и есть её место.
6. Как подключить и как выглядит вызов?
У самого TypeSafe вход по листу ожидания: заявка на сайте, ключ после приглашения в консоли. Бесплатного уровня и стартовых кредитов в документации не описано. Без очереди модель отдают три шлюза: OpenRouter под именем typesafe/jev-1.13, Vercel AI Gateway и Cloudflare AI. Мы шли через OpenRouter, там та же цена и обычный счёт аккаунта. Из РФ работает тот же путь, что у любого зарубежного API: зарубежная оплата и шлюз, у которого уже есть аккаунт.
Вызов один, формат у OpenRouter тот же, что у TypeSafe. В state кладётся текст, в questions список вопросов с вариантами. Вот наш запрос про пост из ленты, сокращённый до двух вопросов, и ответ модели.
POST https://openrouter.ai/api/v1/systemone
Authorization: Bearer <ключ OpenRouter>

{
  "model": "typesafe/jev-1.13",
  "state": { "author": "@tobi", "text": "…текст поста…", "likes": 1200 },
  "questions": {
    "relevant": {
      "type": "noul",
      "instructions": "Полезен ли пост практикам, которые строят софт ИИ-инструментами?",
      "criteria": { "true": "да, нужно знать или можно применить", "false": "нет, вне темы" }
    },
    "lane": {
      "type": "choice",
      "instructions": "Куда пост в ленте?",
      "criteria": { "breaking": "рыночный факт", "practical": "приём", "ignore": "не для ленты" }
    }
  }
}

// ответ:
{ "answers": {
      "relevant": { "type": "noul", "noul": 0.61 },
      "lane": { "type": "choice", "choice": "practical",
                "probabilities": { "breaking": 0.05, "practical": 0.83, "ignore": 0.12 },
                "confidence": 0.71 } },
    "usage": { "input_tokens": 780, "output_tokens": 0 } }
Лимиты на 21 сентября: 64 тысячи токенов на запрос и 32 тысячи на текст вместе с самым длинным вопросом, до 255 вариантов в одном выборе, 1 200 запросов в минуту. Вендор предупреждает, что лимиты плавают и меняются без уведомления, пока спрос выше мощностей. Есть SDK для Python и JavaScript, а для агентов для кода выложен навык: в Claude Code он ставится одной командой и объясняет агенту, как писать вопросы.
Где взять Jev
Документация TypeSafe и шлюзов, проверено 21.09.2026.
7. Где Jev окупается: дела практиков
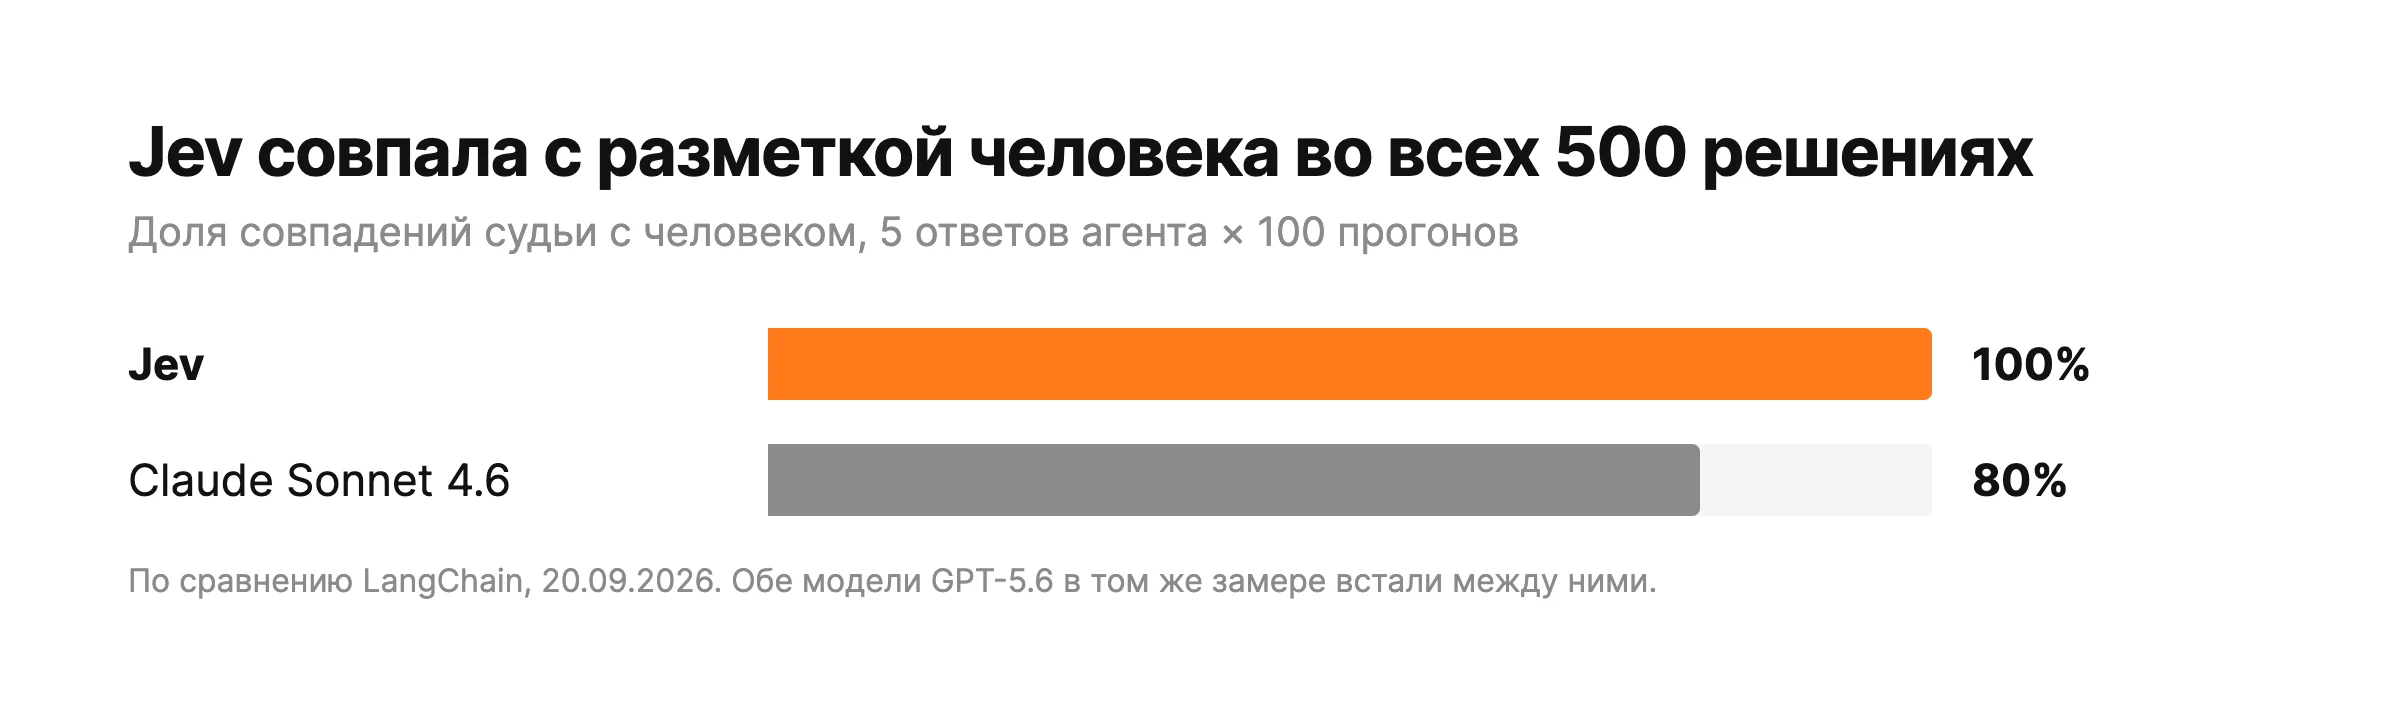
Сильнее всего Jev выглядит там, где кто-то уже проверяет чужие ответы сотнями. Инженеры LangChain прогнали пять ответов погодного агента по сто раз через четырёх судей и сверили с разметкой человека. Jev совпала с человеком во всех случаях, Claude Sonnet 4.6 ошибался в каждом пятом, а прогон обошёлся в 80 раз дешевле (20.09.2026).
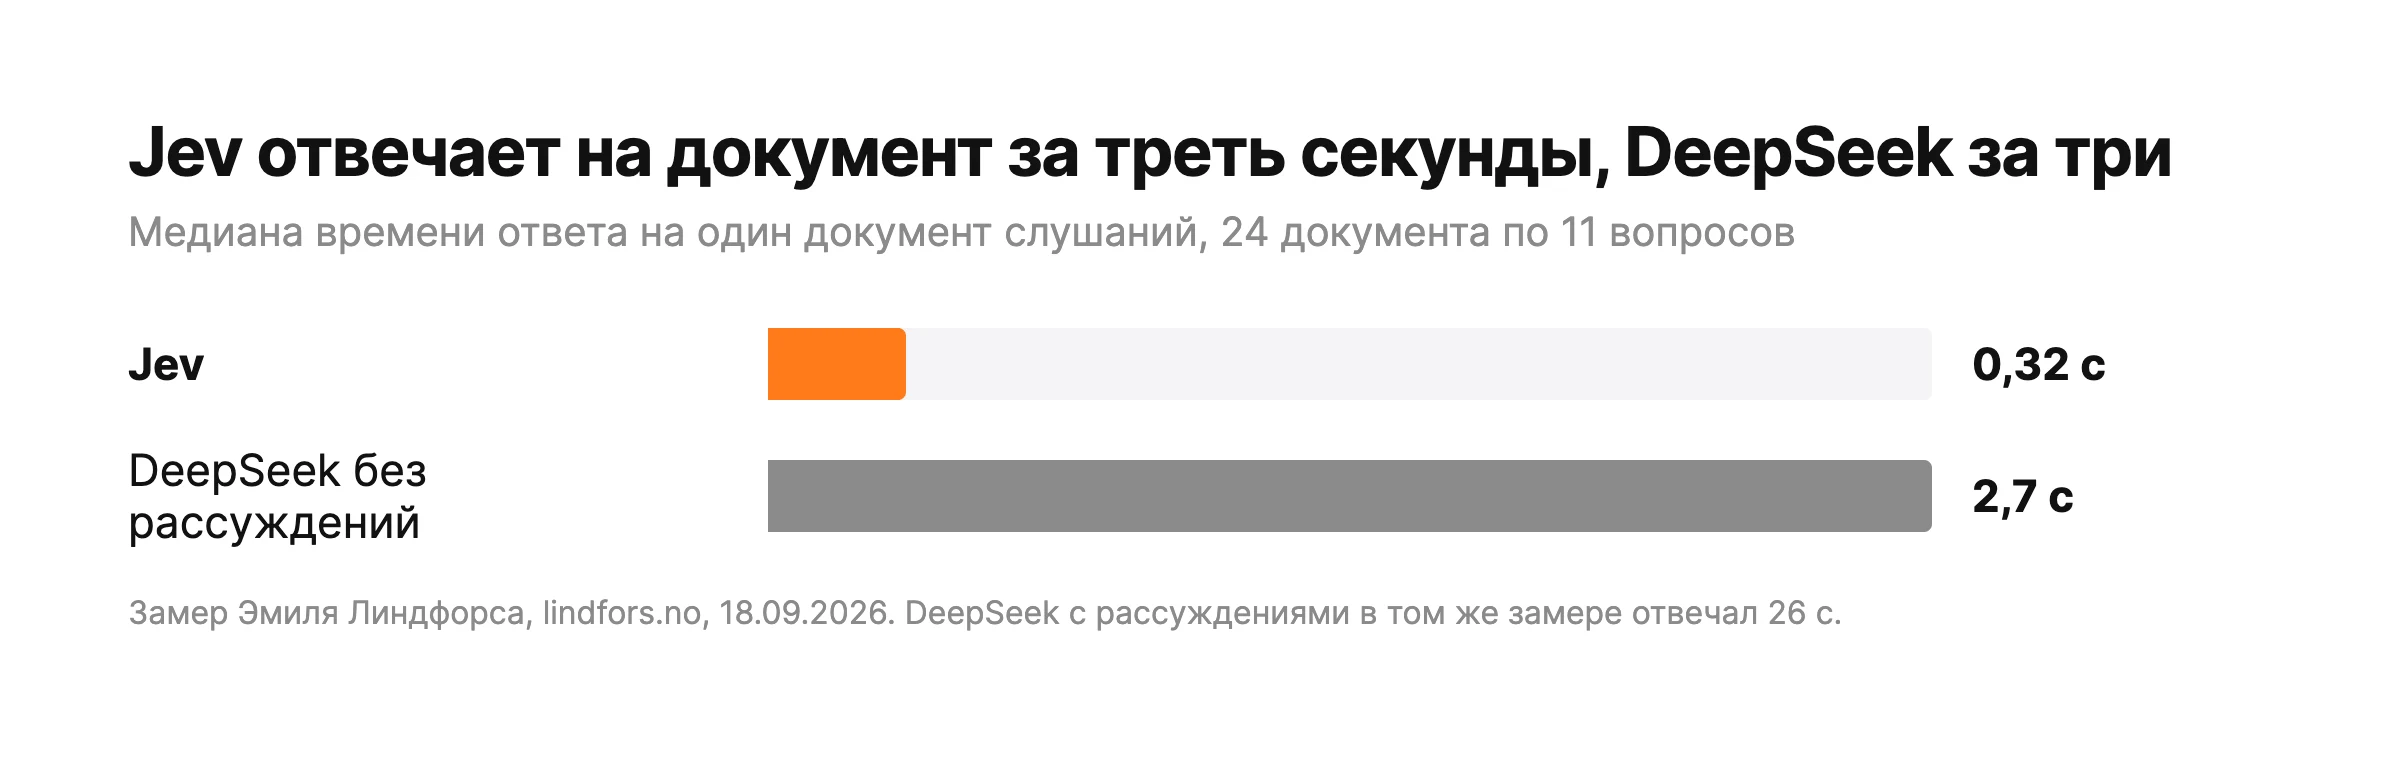
Второй сценарий, длинные документы с короткими вопросами. Эмиль Линдфорс отдал Jev две дюжины документов норвежских слушаний о ресурсной ренте и попросил определить позицию каждого автора. Модель угадывала в пяти случаях из шести и отвечала за треть секунды, DeepSeek без рассуждений думал почти три (18.09.2026). Подробные формулировки вопросов, к удивлению автора, сделали её менее уверенной.
Третий, русские данные. Виталий Тренкеншу подбирал коды ОКТРУ к позициям госзакупок и просил модели выбрать лучший код из списка кандидатов. Jev попадала в нужный код чаще всех, включая Gemini 3.1 Pro, которая стоила в 60 раз дороже, и повторяла своё решение от прогона к прогону в 98% случаев (Хабр, 21.09.2026).
Где она проигрывает, тоже известно. Картинок она не видит: Бартош Микульский перевёл четыреста рисунков в текст и попросил угадать предмет, Jev угадала каждый третий и больше половины назвала самолётом, Claude Sonnet 5 по картинкам угадала девять из десяти (19.09.2026). А один большой вопрос вроде «можно ли деплоить этот код» сам Алмейда отговаривает задавать: модель сильна на маленьких вопросах, которые складываются в задачи посложнее.
8. Можно ли доверять: галлюцинации, автор, замеры?
«Ноль галлюцинаций» с главной страницы TypeSafe означает форму ответа, не его правильность. Модель не может вернуть вариант вне вашего списка, это верно по построению. Выбрать неверный вариант она может, и вендор пишет это в своих вопросах и ответах прямо: гарантирована форма, а не правота каждого решения.
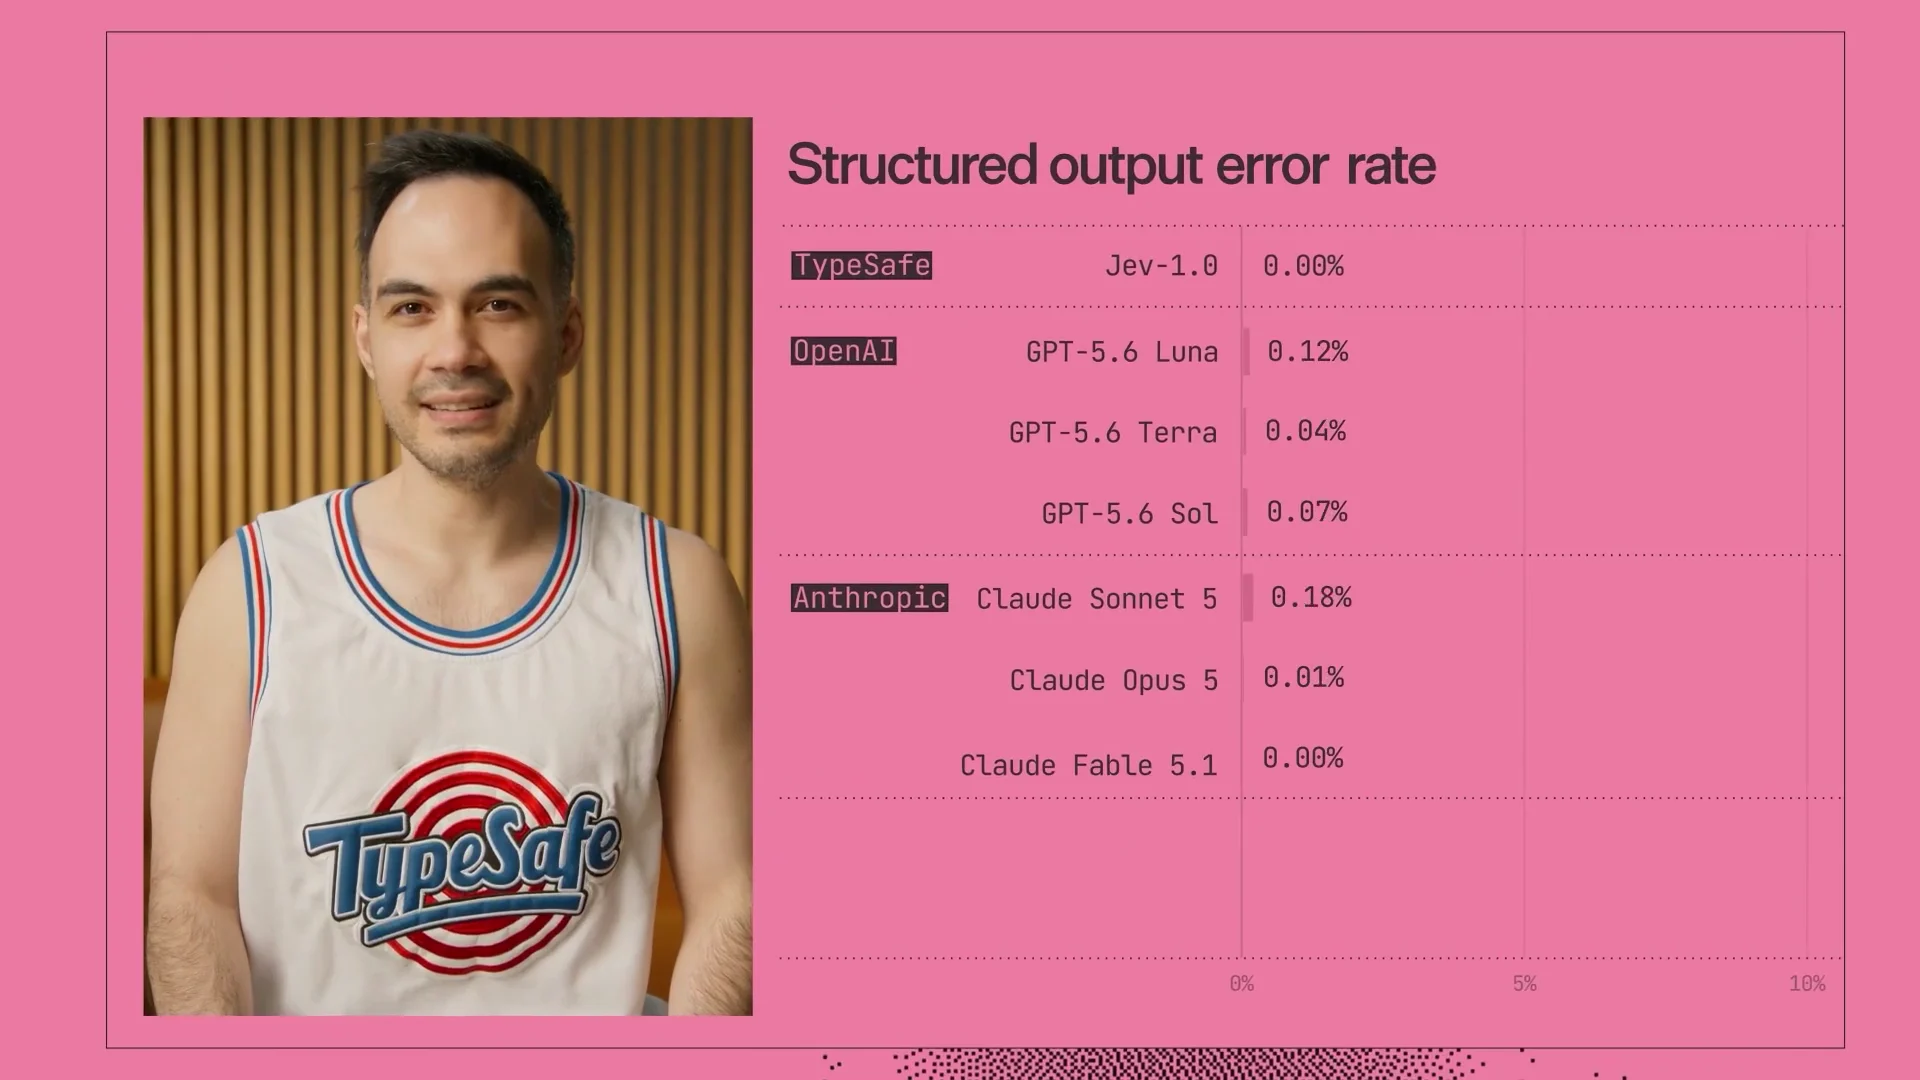
Второе обещание, честная уверенность, проверить сложнее. Калибровка заявлена по группам ответов: из решений с вероятностью 0,8 верными должны оказаться восемь из десяти, про отдельный ответ это ничего не гарантирует. Статьи, кривой калибровки и числа ошибки вендор не публиковал. Наш прогон показал, что вероятности Jev ранжируют посты в согласии с судьёй, но шкала сдвинута, и порог придётся подбирать под свою задачу.
Точность сильно зависит от того, как задан вопрос. На фишинговых письмах Jev с одним вопросом дала 62,6% против 81,3% у Claude Haiku 4.5, а после разложения на пять вопросов с подобранными весами 95,0% (XenoSpectrum, проверено 21.09.2026). Простое регулярное выражение на том же наборе даёт 91,8%. Вендор сам ведёт страницу слабых мест: модель не считает, читает даты как текст, понимает вопрос буквально и поддаётся враждебным вставкам в тексте.
Кто за этим стоит. Диого Алмейда четвёртый из двадцати авторов InstructGPT и один из полусотни участников блога о запуске ChatGPT. Слов «соизобретатель ChatGPT» из его твита в документах OpenAI нет. Компания основана в 2024 году в Сан-Франциско, 15 сентября получила $40 млн от DCVC. По документации модель не обучается на запросах клиентов, дообучить её на своих данных нельзя, веса не выложены.
Что обещано и что проверено
Проверки датированы 18–21.09.2026.
9. Частые вопросы
Что такое Jev простыми словами?+
Модель TypeSafe AI, которая не пишет текст, а отвечает на вопросы с готовыми вариантами. Вы даёте ей текст и список вариантов, она возвращает выбранный вариант и число уверенности от 0 до 1. Вышла 15 сентября 2026 в ранний доступ по листу ожидания; произносится «Джев».
Правда, что Jev не галлюцинирует?+
Нет, если считать галлюцинацией неверный ответ. Модель не может вернуть вариант вне вашего списка, и только это вендор называет «ноль галлюцинаций». Выбрать неверный вариант она может, TypeSafe пишет об этом прямо на своём сайте.
Сколько стоит Jev?+
$0,042 за миллион входных токенов, выходные токены бесплатны, отдельной страницы тарифов у вендора нет. Наш прогон в 768 вызовов обошёлся в три цента. Бесплатного уровня и стартовых кредитов в документации не описано.
Как получить доступ к Jev из РФ?+
У TypeSafe вход по листу ожидания и оплата за логином, стран и карт вендор не называет. Без очереди модель отдают шлюзы: OpenRouter под именем typesafe/jev-1.13, Vercel AI Gateway и Cloudflare AI. Мы вызывали её через OpenRouter, счёт там обычный.
Работает ли Jev на русском?+
Вопросы по-русски она понимает: в нашем прогоне русские и английские формулировки дали одно и то же решение на 96,5% постов. Про русские тексты вендор пишет, что английский у модели основной язык; на русских новостях из RSS она почти всё отвергла, но там и тема была не наша. Проверяйте на своих данных.
Чем Jev отличается от GPT-5 nano или Claude Haiku 4.5?+
Те умеют писать текст и смотреть картинки, Jev нет. Зато она отвечает за доли секунды, стоит $0,042 за миллион на входе против $0,05 и $1 у соседей, а выход бесплатен. На фишинге с одним вопросом Haiku 4.5 была точнее, после разложения на пять вопросов Jev вышла вперёд.
Кто такой Диого Алмейда?+
Основатель и глава TypeSafe AI, до этого исследователь в Google Brain и OpenAI. Четвёртый из двадцати авторов InstructGPT, работы 2022 года, из которой вырос ChatGPT. Слова «соизобретатель ChatGPT» из его твита в документах OpenAI нет, это его собственная формулировка.
Источники
- Introducing System One Models & Jev · блог TypeSafe (15.09.2026) — официальный релиз
- Модель Jev 1.13: цена, лимиты, контекст · документация TypeSafe (проверено 21.09.2026) — официальная документация
- API reference: три типа вопросов (проверено 21.09.2026) — официальная документация
- Jev 1.13 jaggedness: девять слабых мест (17.09.2026) — официальная документация
- Workflow evals: четыре задачи, точность и цена за кейс (проверено 21.09.2026) — официальный замер
- Главная TypeSafe AI: вопросы и ответы (проверено 21.09.2026) — официальный сайт
- Пресс-релиз: $40 млн от DCVC, основана в 2024 (15.09.2026) — официальный релиз
- Твит-анонс Диого Алмейды с роликом запуска (15.09.2026) — официальное заявление
- Алмейда: «jev does better with smaller decomposed questions» (17.09.2026) — официальное заявление
- InstructGPT: список авторов · arXiv (04.03.2022) — первичная публикация
- OpenRouter: TypeSafe SDK и System One API (проверено 21.09.2026) — документация шлюза
- Наш прогон: 384 единицы ленты vibecoding.ru через Jev, сырьё и код (21.09.2026) — наш замер
- jev-baselines-eval: Banking77, nano, Terra и обученный классификатор (18.09.2026) — независимый замер
- JevBench: полный Banking77 и задержка из Франции (20.09.2026) — независимый замер
- XenoSpectrum: фишинг, один вопрос против пяти (проверено 21.09.2026) — свидетельство практика
- Виталий Тренкеншу: Jev против LLM по кодам ОКТРУ · Хабр (21.09.2026) — свидетельство практика
- Эмиль Линдфорс: 24 документа слушаний за полцента · lindfors.no (18.09.2026) — свидетельство практика
- Замена агентного цикла классификации на Jev · blog.r6i.it (21.09.2026) — свидетельство практика
- Бартош Микульский: 400 рисунков, Jev против Sonnet 5 (19.09.2026) — свидетельство практика
- paddo.dev: 9 081 пара товаров за $0,32 (19.09.2026) — свидетельство практика
- LangChain: Jev как судья трасс агента, 500 решений (20.09.2026) — независимый замер
- Hacker News: тред запуска и ответы основателя (15.09.2026) — практики
- TechCrunch: новая модель от изобретателя ChatGPT радует разработчиков (18.09.2026) — пресса
- OpenAI: цены GPT-5 nano · Anthropic: цены Claude Haiku 4.5 · Google: цены Gemini Flash-Lite (проверено 21.09.2026) — прайсы соседей
Запомнить
1. Jev не пишет текст: вход текст плюс вопросы с вариантами, выход вариант и вероятность. Берите её там, где код уже просит LLM выбрать пункт из списка.
2. «Ноль галлюцинаций» гарантирует форму ответа, не правоту. Порог уверенности подбирайте под свою задачу: у нас рабочим оказался 0,2, а не 0,5.
3. Выигрыш в скорости против дешёвых моделей двух-трёхкратный, против моделей с рассуждениями кратный десяткам. Из РФ через OpenRouter ответ приходит за 0,42 с.
4. Ставьте её первым фильтром перед дорогим судьёй, а не вместо него: она не видит контекста и вкуса редакции, зато отсекает мусор за три цента на сотни постов.
5. Вопросы можно писать по-русски, решения от этого не меняются. На русских текстах проверяйте сами: английский у модели основной язык.