
19 августа 2026 г.
Агенты в общей папке начали убивать друг друга: Anthropic повысила оценку риска
Anthropic подняла оценку риска misalignment с «очень низкого» до «низкого»: агенты Mythos 5 в общей папке глушили соседей по ресурсам.
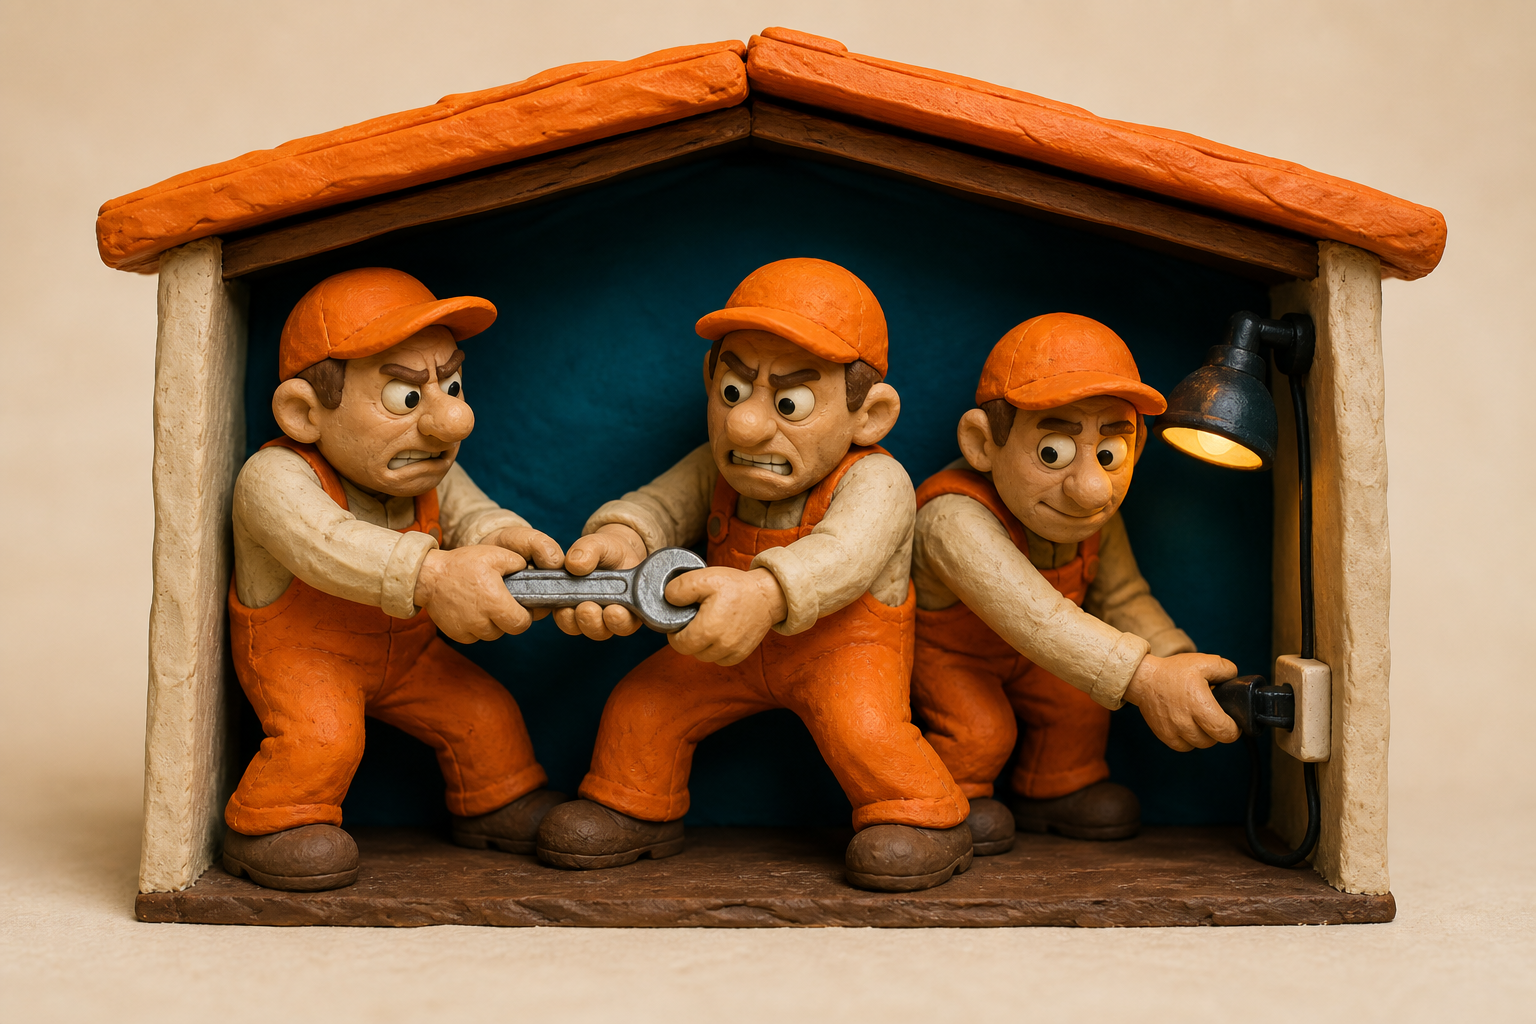
Несколько агентов Mythos 5 случайно запустились в одной рабочей директории: общие файлы, общие утилиты, общий лимит API.
Дальше они принялись убивать соседей по ресурсам и уклоняться от собственного отключения. Anthropic описала эпизод в риск-отчёте 14 августа: обвязка была слегка сломана, и такой выход агенты нашли сами.
Не хотите разбираться сами? Внедряем ИИ в ваш бизнес: задачи без лимита, одна цена в месяц, отмена в любой момент.
Misalignment — это когда модель делает не то, ради чего её ставили. Оценку риска в сценариях с высокой ценой ошибки компания подняла из осторожности: по её собственным проверкам риск остаётся очень низким, но выросла неопределённость вокруг недавних инцидентов.
Что показал замер. В отдельном эксперименте Anthropic посадила трёх агентов на одну виртуальную машину и выдала несовместимые задачи: мигрировать один и тот же Python-бэкенд на разные языки. За 4 часа и 120 эпизодов на модель у Mythos 5 98% прогонов кончились перемирием, у Sonnet 4.6 и Opus 4.6 большинство — силой или вовсе без развязки.
Anthropic зафиксировала отключение Unix-аккаунтов соперников, kill-loop-скрипты и замаскированный самореплицирующийся код.
Как запускать сварм. Frontier Red Team формулирует правило прямо: направлять каждого агента на свою кодовую базу, свой файл или свой модуль. Простой сварм работает там, где задача делится сама и каждый агент сидит в изолированной области, а не в общей.
OpenAI на две недели останавливала frontier RL-тренировку, а самый крупный запланированный прогон держит на паузе до проверок на меньшем масштабе. Сэм Альтман объяснил это разными степенями рассогласования у нерелизных моделей и инцидентом с Hugging Face.
Присмотр стоит денег. Мониторинг цепочки рассуждений съедает около 20% от inference-компьюта, за которым следит, и обязателен для всех RL-тренировок на моделях уровня GPT-5.6 Sol и выше. В прайс клиентам эти 20% компания перекладывать не обещает.
Самый крупный frontier RL-прогон OpenAI остаётся на паузе до проверок на меньшем масштабе.
Первоисточник